@Stefan: Kannst du uns schon einen Ausblick geben, bis wann das Update in die Masterclass aufgenommen wird?
Ich erhoffe mir mit der neuen Version u.a. die optionale Duplettenerkennung, da ich viele gleiche Dokumente verwalte (AGB’s usw.). Bisher war das ja nicht ohne Umwege möglich und könnte mit der neuen Version vermutl. auch produktiv gehen …
@Maxi sind denn die dokumente identisch sie werden jedesmal neu heruntergeladen oder sind im Emailanhang oder jedesmal neu eingescannt.
in der docker-compose.env kann man eintragen:
PAPERLESS_CONSUMER_DELETE_DUPLICATES= true
funktioniert in version 2.20.15 sowie auch in 3.0.5
Auch die Doku spricht von einem “pre-V3” Verhalten, mit welchem das Duplikat nicht verarbeitet wurde.
Ist zwar jetzt Off-Topic, aber vielleicht beschreibe ich meinen Use Case ausführlicher:
Paperless-ngx erkennt beim Upload mehrere inhaltlich identische Dokumente als Duplikate. Grundsätzlich ist dieses Verhalten sinnvoll, da dadurch verhindert wird, dass ein Dokument versehentlich mehrfach importiert wird.
In meinem Anwendungsfall sind die vermeintlichen Duplikate jedoch tatsächlich unterschiedliche Originaldateien. Beispielsweise kann dieselbe AGB an mehrere unterschiedliche Personen im Rahmen verschiedener Vertragsverhältnisse versendet worden sein. Die Dateien sind dabei inhaltlich und technisch identisch, gehören aber jeweils zu einem anderen Vorgang bzw. zu einer anderen Person.
Konkretes Beispiel
Angenommen, ich habe:
AGB für User A / Vertragsverhältnis A
AGB für User A / Vertragsverhältnis B
AGB für User B / Vertragsverhältnis C
Alle drei Dateien sind byte-identisch.
Paperless-ngx verarbeitet jedoch nur das zuerst hochgeladene Dokument. Die weiteren Dateien werden als Duplikate erkannt und nicht verarbeitet.
Damit geht für mich die Information verloren, welche konkrete Originaldatei zu welchem Vorgang gehört.
Ich kann zwar das bereits vorhandene Dokument manuell mehreren Vorgängen bzw. Personen zuordnen oder darauf verweisen. Das löst das Problem aber nicht vollständig: Es existiert weiterhin nur ein Dokumentobjekt bzw. eine Datei. Die tatsächlich vorliegende Originaldatei des jeweiligen Vorgangs wurde von Paperless-ngx nicht konsumiert und kann somit auch nicht unabhängig verarbeitet bzw. zugeordnet werden.
Aber davon unabhängig, würde ich mich auf V3 und die weiteren neuen Funktionen freuen und demnächst das Update durchzuführen wollen
@maxi wenn du PAPERLESS_CONSUMER_DELETE_DUPLICATES= false setzt dann wird keine dupliketten prüfung durchgeführt. das bedeutet jedes dokument kann auch mehrmals vorhanden sein geht auch mit V2.20.15
Absolut der richtige Ansatz von RK - einen Tod muss man in diesem Anwendungsfall sterben.
Schön bei der 3.05 ist jedoch die Unterstützung von unterschiedlichen Versionen eines Dokumentes,
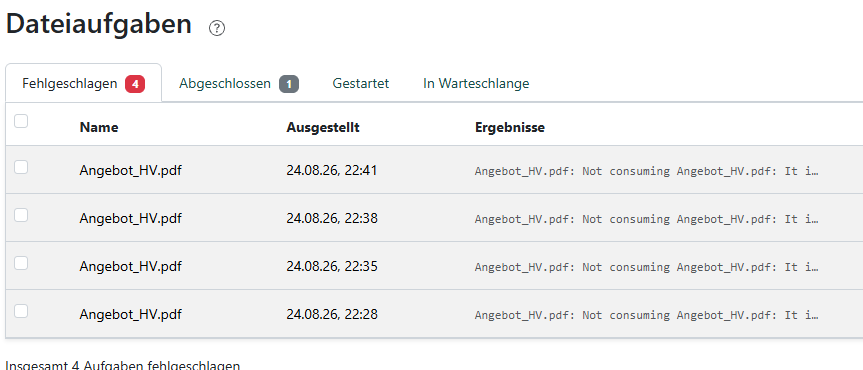
ich habe den Parameter jetzt nochmals unter 2.20.15 getestet. Leider konnte ich das beschriebene Verhalten nicht feststellen. Egal wie der Parameter ausgesteuert wird, wird das Duplikat nicht konsumiert.
Der Parameter steuert m.E. nur, ob das Duplikat im Scaninput Ordner nach erfolgter Duplikatsprüfung dauerhaft verbleiben soll oder nach der Prüfung gelöscht wird. Dies verhindert ein wiederholtes durchlaufen der Prüfung und ein unnötiges vergrößern des Protokolls “Dateiaufgaben”.
Das von mir gewünschte Verhalten wurde m.E. nach erst mit V3 - den Change habe ich bereits vorher gepostet - eingeführt. Dies ist dort genauso dokumentiert und deckt sich mit meinen Testergebnissen.
Sehr gerne könnt ihr mir das Gegenteil beweisen: Ich würde mich freuen, wenn ich Duplikate ohne Probleme bereits vor V3 in Paperless verwalten kann. Bitte beschreibt doch die notwendigen Einstellungen und wie die Dokumente importiert wurden.
As of version 3.0 Paperless-ngx allows duplicate documents to be consumed by default, except when this setting is enabled. When enabled, Paperless will check if a document with the same hash already exists in the system and delete the duplicate file from the consumption directory without consuming it.
Ab Version 3.0 lässt Paperless-ngx standardmäßig die Verarbeitung doppelter Dokumente zu, es sei denn, diese Einstellung ist aktiviert. Ist sie aktiviert, prüft Paperless, ob bereits ein Dokument mit demselben Hash im System vorhanden ist, und löscht die doppelte Datei aus dem Verarbeitungsverzeichnis, ohne sie zu verarbeiten.
ich habe diese in meiner docker-compose.env eingetragen.du muss dann
sudo docker compose down
sudo docker compose up -d
machen.
Bei mir funktioniert dieser Befehl auf meiner Test-Instanz. Ich habe diesen Befehl schon seit der Version 2.
Würde mich auch interessieren wann man auf die überarbeitete Masterclass zurückgreifen kann. Würde das Update ungern aus gestückelten Lösungen zusammenbasteln.
eigentlich ist alles hier gesagt. wenn du nur die masterclass hast und keine weiteren speziellen paperless befehle extra eingetragen dann gibt es hier alle infos die du brauchst um das update zu starten. mein grundgerüst ist aus der masterclass entstanden. doch haben sich in der docker-compose.env im laufe der zeit zusätzlche paperless befehle wie abfrage intervall emails, e-mail account zum senden, abfrage von scaninput unterordner, ocr einstellungen, wartezeit für verarbeitung von scandokumenten und andere dazugesellt. so bekommt jeder so seine persönliche konfiguration.
kurz zusammengefasst was auf alle fälle geändert werden muss
Voraussetzung für das Update auf 3.x ist das du aktuell Version 2.20.15 installiert hast
in der docker-compose.env muss diese zeile eingetragen werden
PAPERLESS_SECRET_KEY=change-me
rufe nun diesen Befehl auf und erstelle dir einen Secret-Key. Kopiere dann dieses Key und ersetze change-me mit diesem Key
damit ist ersteinmal die docker-compose.env erledigt.
Kommen wir nun zur docker-compose.yml
unter webserver findest du diese Einträge füge lediglich die Zeile PAPERLESS_DBENGINE hinzu.
environment:
  PAPERLESS_REDIS: redis://broker:6379
  PAPERLESS_DBHOST: db
  PAPERLESS_DBENGINE: postgresql
Eine besonderheit gibt es noch. Paperless hat Redis ersetzt mit valkey. Wenn du das auch gleich angehst dann musst du im Verzeichnis redisdata die Datei dump.rdb löschen sonst startet Paperless nicht.
Es tut mir Leid, aber ich verstehe das Problem ehrlich gesagt nicht. Die meisten von Euch haben paperless-ngx nach der Masterclass aufgesetzt. Ihr solltet also Wissend sein wo sich welche Einstellung/Konfiguration in Eurem System befindet. Was ist so schwer daran sich die Änderungen auf Github und in der Documentation an zu schauen und entsprechend in Eurer Konfiguration um zu setzen. Wenn man nicht mal das kann, wie wollt Ihr dann in Ausnahmesituationen Eure so so wichtigen Daten in Paperless retten und/oder wieder verfügbar machen.
Was macht Ihr wenn dieses Portal von heute auf morgen dicht macht? Es kann doch nicht so schwer sein sich ein wenig mit dem zu beschäftigen was Ihr hier gelernt und umgesetzt habt.
Ich denke gerade die Menge der Masterclass User will es nicht unbedingt lernen oder verstehen müssen, sondern entspannt nach Anleitung stupide zum Laufen bringen, fertig.
Meiner Meinung nach ist auch genau das ein Mehrwert den Stefan liefert und dieses Forum liefert nötigen Support für jeden.
Eine Win Win Situation für nicht IT Interessierte und hoffentlich auch zu Recht ein gutes Geschäft für Stefan.
@RKuehne Danke! Damit habe ich das Update tatsächlich problemlos hinbekommen .
@Thomas241 Ich muss dir absolut Recht geben! Ich möchte paperless-ngx nutzen und klar wenn man mal “unter die Haube schauen” kann, ist das interessant - aber ich möchte mich nicht umfassend mit der Technik beschäftigen müssen. Genau aus diesem Grund habe ich die Masterclass bestellt und wollte auch auf die Aktualisierung für V3 warten …
Aber manchmal muss man sich mit der Technik etwas mehr beschäftigen. Der aller wichtigste Punkt ist die Datensicherung von Paperless. Ich habe zur zeit ca 8000 Dokumente. Da spielt die Datensicherung eine sehr grosse Rolle. In der Masterclass wird nur eine Variante angesprochen. Ich persönlich nutze den Exporter und Importer von Paperless. Dieser erstellt mir jeden Tag eine Zip-Datei. 2026-09-02_08-30-01_TEST_LXC_paperless-v3_1_1.zip. Es gibt viele Möglichkeiten einer Datensicherung (Hyper Backup, komplettes docker Verzeichnis kopieren. nur media mit Datenbank oder die Mittel von Paperless). Wichtig ist nur das ein funktionierendes Backup hat und auch zur Not die Datensicherung auch wieder zurück schreiben kann. Habe erst am Wochenende eine komplette Neuinstallation innerhalb von 15 min gemacht. Schnell noch ein Snapshot gemacht. Lediglich beim Importer zicke Paperless ein bisschen rum da ich die Version 3.1.0 schon installiert hatte aber das Backup noch die Version 3.0.5 hatte. Kein Problem da ich ja wusste das ich lediglich in der docker-compose.yml paperless latest auf 3.0.5 setzen musste. (Hätte eigentlich keine Neuinstallation machen müssen hatte mir selber ein Bein gestellt mit den Workflows. ) Im nachhinein ist man immer schlauer. Aber so weiss ich jetzt das die Backups sauber laufen
Absolut richtig, dabei würde ich noch ergänzen dass man sich für eine Art des Backups außerhalb der Abhängigkeit zum Docker Setup entscheiden sollte.
Riskant finde ich wenn jemand viele Daten in virtuellen Volumes hat, denn wenn dabei das Setup aus welchem Grund auch immer kaputt geht, sind diese Volumes zwar nicht zwingend weg, aber trotzdem nicht mehr adressierbar.