KI-Projekt für Paperless - eure Erfahrungen

Hallo zusammen,

ich habe meinen bisherigen Rechnungs-Workflow bereits in diesem Beitrag vorgestellt: Workflow für Rechnungswesen gesucht.

Nun möchte ich den Prozess um lokale KI erweitern. Ziel ist, dass eingehende Rechnungen möglichst automatisch klassifiziert werden und anschließend nur noch von einer Person kontrolliert bzw. freigegeben werden müssen.

Meine Rahmenbedingungen:

  • Budget: ca. 1.000–1.300 €, gerne weniger

  • Betrieb lokal über Ollama

  • Falls eine Chat-Funktion integriert ist: maximal fünf Nutzer

  • Rechnungsvolumen: ca. 100 Rechnungen pro Monat

Ich stelle mir aktuell folgenden Ablauf vor: Eine Rechnung wird in Paperless eingelesen, anschließend soll die KI die relevanten Attribute erkennen bzw. vorschlagen, zum Beispiel:

  • Rechnungsdatum

  • Rechnungsnummer

  • Korrespondent

  • Rechnungsbetrag

  • Sachkonto

  • Kostenstelle

Für Sachkonto und Kostenstelle habe ich bereits eine Excel-Liste mit den entsprechenden Beschreibungen, die ich jedoch auch in eine Datenbank überführen kann. Beispielsweise könnte dort hinterlegt werden, dass die Kostenstelle 10 für interne Arbeiten verwendet wird. In Paperless würde ich dann als Custom Field lediglich die Nummer der Kostenstelle speichern.

Frage zum Workflow

Würdet ihr für die KI-gestützte Klassifizierung eher eine Kombination aus Ollama und n8n einsetzen? Stefan hatte diesen Ansatz meines Wissens nach bereits in einem YouTube-Video erwähnt (https://youtu.be/fP9ugQu6VXk?si=WJMpT2W3_RmQPzbh).

Oder wäre Paperless-AI dafür die bessere Wahl, da es direkt an Paperless angebunden ist und gegebenenfalls auch eine Chat-Funktion für die Nutzer bietet?

Mein Ziel wäre, dass die KI die Daten möglichst zuverlässig vorschlägt und ein Mitarbeiter anschließend nur noch kontrollieren und bei Bedarf korrigieren muss. Wichtig wäre mir außerdem, dass die Kostenstellen- und Sachkontenlogik möglichst nachvollziehbar und wartbar bleibt.

Frage zur Hardware

Stefan hatte mehrfach erwähnt, dass ein Mac mini für lokale KI interessant sein kann, da er im Vergleich zu einem klassischen Linux-Server mit geeigneter GPU oft ein gutes Preis-Leistungs-Verhältnis bietet.

Habt ihr hierzu Erfahrungen oder konkrete Hardware-Empfehlungen? Ich bin gerade unsicher, welche Hardware für meinen Anwendungsfall sinnvoll wäre und ob Paperless-AI oder ein individueller Workflow über n8n langfristig die bessere Lösung ist.

EDIT: Hier bekommt man z. B. für 1500,- Euro einen MacMini mit M6 und 32GB Speicher Mac mini kaufen - Apple (DE)

Vielen Dank für eure Erfahrungen und Empfehlungen!

Viele Grüße
Marco
Hallo Marco,

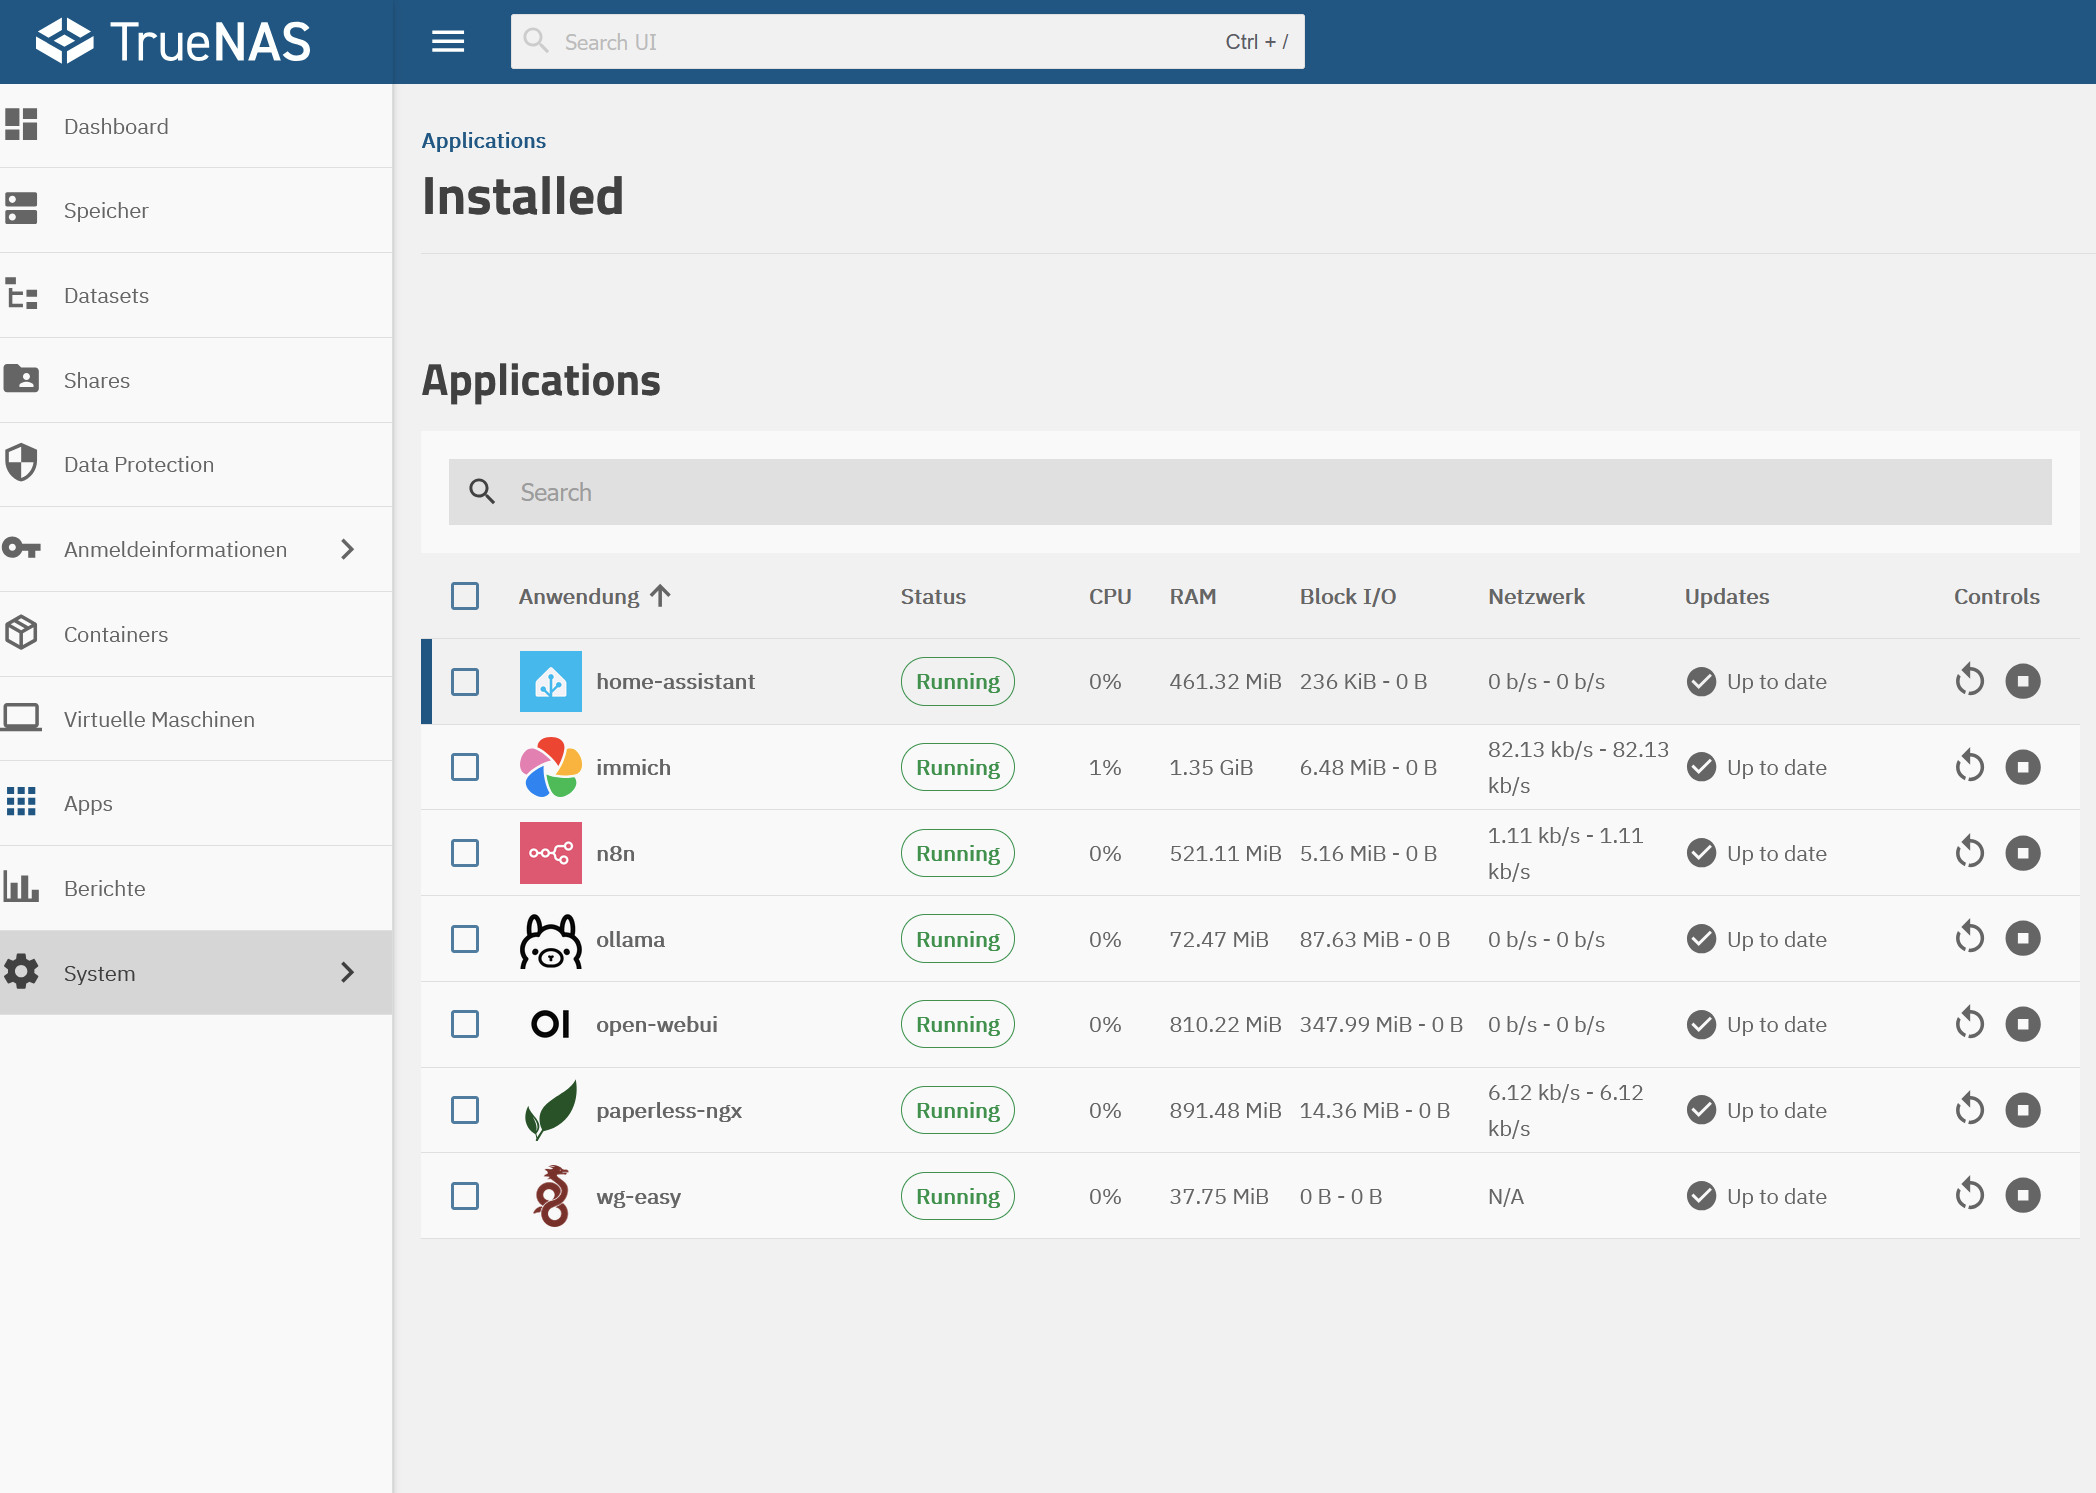
ich habe bereits etwas Ähnliches für einen Handwerker aufgebaut. Bei mir läuft TrueNAS 26 mit Paperless-ngx, Ollama, Open WebUI und n8n lokal auf dem Server.

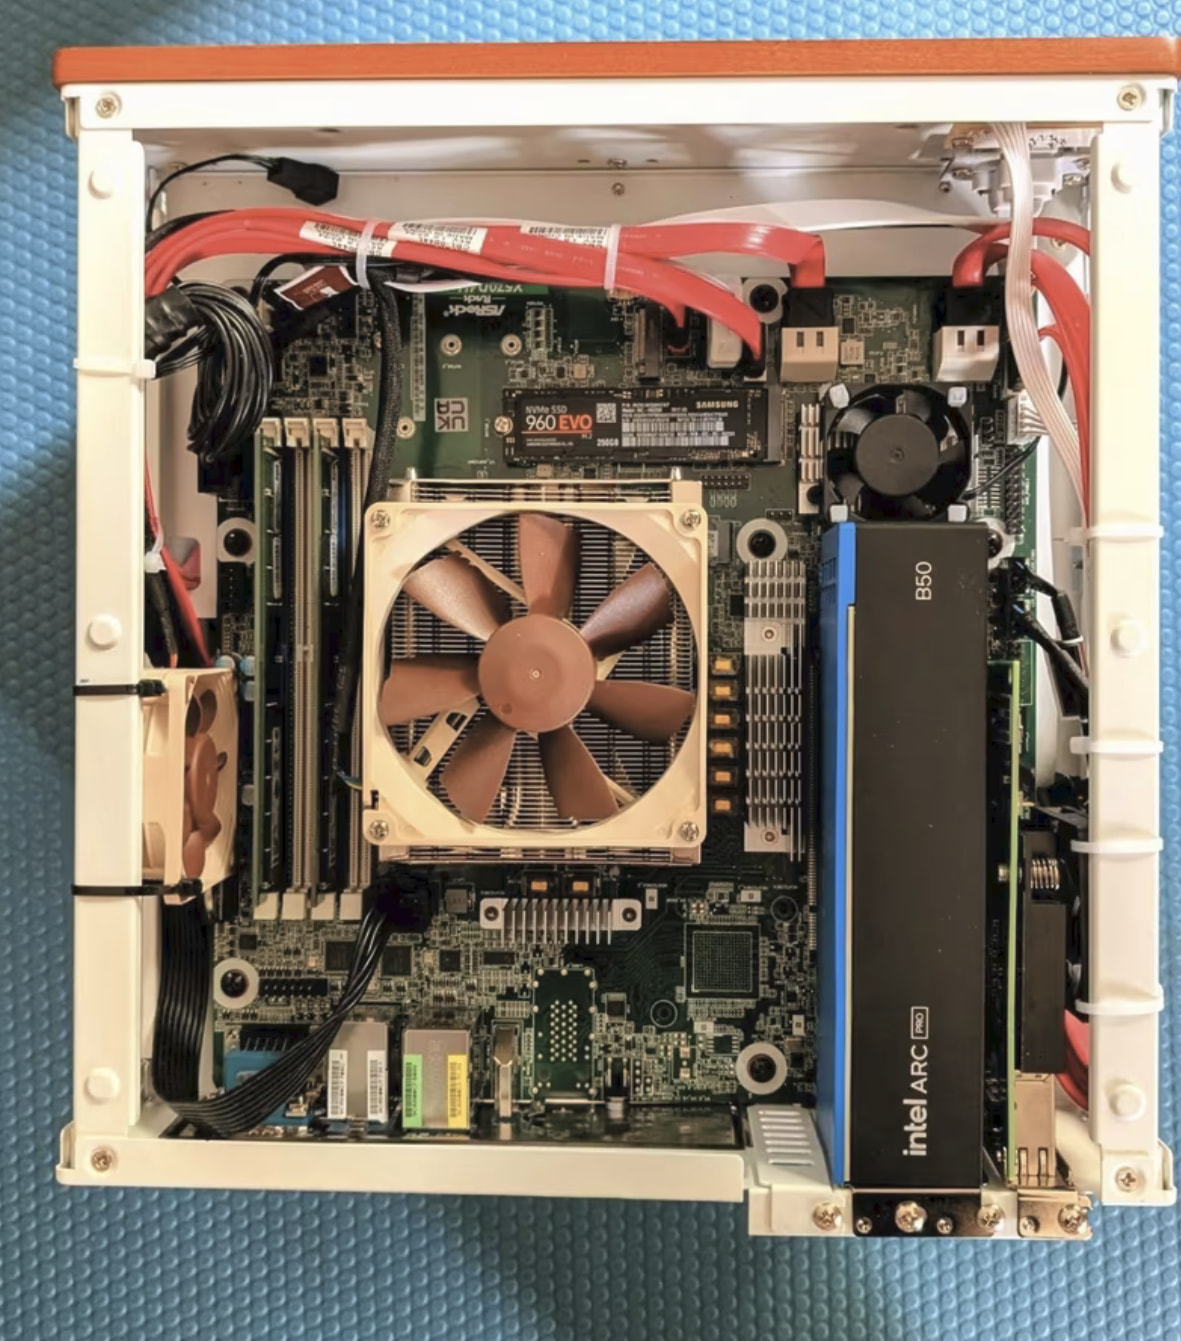
Da TrueNAS 26 inzwischen Intel Arc unterstützt, habe ich eine Arc Pro B50 mit 16 GB GDDR6 für die lokale KI verbaut. Als Scanner kommt ein Epson ES-580W zum Einsatz, der die Dokumente direkt in den Paperless-Workflow scannt.

Beim Mainboard waren mir 10 Gbit LAN, IPMI und ECC-Unterstützung wichtig – gerade für einen Server, der dauerhaft laufen und wichtige Dokumente verwalten soll.

Für deinen Anwendungsfall mit ca. 100 Rechnungen im Monat finde ich die Kombination aus Paperless + Ollama + n8n durchaus interessant, weil man die Klassifizierung und die Regeln für Sachkonto/Kostenstelle sehr flexibel selbst definieren kann.

Viele Grüße

Hi @JoD,
vielen Dank für deinen Vorschlag!

Was ich gelesen habe ist, das teilweise schon für eine Spielweise man eine wirklich gute Grafikkarte mit ausreichend VRAM benötigt. Laut meinen Quellen wurde geschrieben, das 16GB schon fast zu wenig sind. Anscheinend soll man eher auf 32GB noch besser auf 64GB gehen, damit Ollama richtig läuft und auch sauber funktioniert.

Was sagst du dazu? Läuft Ollama „performant“ bei dir?

Wie genau hast du das ganze umgesetzt - welches NAS-Modell hast du genau und wie hast du da die Grafikkarte verbunden? Wäre das Möglich auch mit einer Synology oder einem Lenovo-Rechner, wo du dann eine externe Grafikkarte ergänzt?

Hallo mka,

ich betreibe einen ähnlichen Workflow seit einiger Zeit als hochperformantes Gesamtsystem.

Hier ist unser erprobter Systemaufbau in Stichpunkten:

  1. Hardware-Architektur & Dual-Knoten
    • Knoten 1 (Storage & Archiv): Synology NAS (revisionssicherer Belegspeicher, Backups & SMB-Share).
    • Knoten 2 (Compute & KI-Workstation):
      PC mit NVIDIA RTX 5060 Ti (16 GB VRAM) (alternativ RTX 4060 Ti 16 GB), Intel Core Ultra / i7 Mehrkern-CPU und 32 GB DDR5 RAM.
      Betriebssystem: Windows 11 Pro mit WSL2 (Ubuntu 24.04) für die gesamte Docker-Pipeline.
  2. Intelligentes KI-Routing (GPU vs. CPU)
    Um die GPU nicht mit trivialen Aufgaben zu blockieren, werden die Lasten strikt aufgeteilt:
    • GPU-Instanz (paperless_ollama_gpu auf Port 11436 / RTX 5060 Ti 16 GB):
      Attribut-Extraktion: qwen2.5:14b / qwen3.5 für strukturierte JSON-Ausgabe (Rechnungsdatum, Beleg-Nr., Kreditor, Netto/Brutto, Steuersätze).
      Vision-OCR bei Problembelegen: qwen2-vl:7b / Keyvan/german-ocr-3.1 für zerknitterte Thermobons, handschriftliche Vermerke oder schräge Smartphone-Fotos.
    • CPU- & RAM-Instanz (WSL2 Docker / Port 11435):
      Vektorisierung (Embeddings): bge-m3 oder nomic-embed-text wandelt Texte in Vektoren um – läuft extrem leichtgewichtig auf der Mehrkern-CPU.
      Vektor-Datenbank (paperless_qdrant auf Port 6333): Hält den semantischen Vektor-Index im RAM für blitzschnelle RAG-Suchen.
    • Workflow-Engine (paperless_n8n auf Port 5678): Reagiert auf Webhooks und steuert die API-Aufrufe.

Phase 1: Pre-Ingest & Triage
Belege kommen via Netzwerk-Scanner, Mail-Abruf oder Ordnerüberwachung in den Eingangsordner (scan_input / consume). Pre-Ingest-Filter: Automatische Duplikatprüfung (Visual Hashing) und PDF-Integritätsprüfung mit pikepdf. Initiales Basis-OCR durch Gotenberg / Tika (Tesseract).

Phase 2: KI-Veredelung & Koordinatengetreuer Textlayer (Sandwich-PDF)
Das ist der entscheidende Unterschied zu einfachen Text-Dumps:Löschung fehlerhafter OCR-Reste: Der alte, zerhackte Tesseract-Layer wird via PyMuPDF (fitz) entfernt, während das Original-Scanbild zu 100 % unberührt bleibt.

Bounding-Box-Erfassung: Jedes Wort wird mit seinen exakten Koordinaten [x0, y0, x1, y1] erfasst.
Lektorat & Fehlerkorrektur: Das LLM bereinigt OCR-Artefakte, schließt Worttrennungen und korrigiert typische Verwechslungen (0 vs. O, 1 vs. l) semantisch aus dem Satzkontext.

Unsichtbare Re-Injektion: Der veredelte Text wird als unsichtbarer Vektor-Layer pixelgenau an den Originalkoordinaten hinter das Scanbild gerendert. Du kannst Text mit der Maus markieren, kopierst den 100 % korrigierten Text heraus und die gelben Such-Marker in Paperless sitzen exakt auf den richtigen Wörtern.

Phase 3: Deterministisches Matching (Kostenstellen & Sachkonten)
Keine LLM-Halluzinationen: Das LLM schlägt lediglich standardisierte Attribute vor (Kreditor, Gegenstand, Betrag).
Tabellen-Lookup in n8n: Deine Excel-/DB-Liste (z. B. Kostenstelle 10 = Interne Arbeiten) wird deterministisch gegen die erkannten Daten gemappt.
Wartung: Neue Kostenstellen werden einfach in der Tabelle ergänzt – kein Prompt-Tuning nötig.

Phase 4: Post-Scan, REST-API & Human-in-the-Loop

Custom Fields: Rechnungsnummer, Fälligkeit, Betrag, Sachkonto und Kostenstelle werden vollautomatisch per Paperless-REST-API befüllt.
Status-Tag: Das Dokument erhält das Tag KI_Prüfung_erforderlich.
Mitarbeiter-Freigabe: 3-Sekunden-Kontrollblick in Paperless → Klick auf Freigegeben → Revisionssicher archiviert.

Phase 5: Multi-User Chat (bis 5 Nutzer)
Open WebUI (paperless_open_webui auf Port 8501) direkt angebunden an Ollama & Qdrant.
Bietet getrennte Benutzer-Accounts mit Rechteverwaltung und erlaubt es, Fragen direkt an den Belegbestand zu stellen („Zeige alle Rechnungen von Lieferant X aus dem 3. Quartal über 500 €“).

Viele Grüße und maximalen Erfolg beim Aufbau!

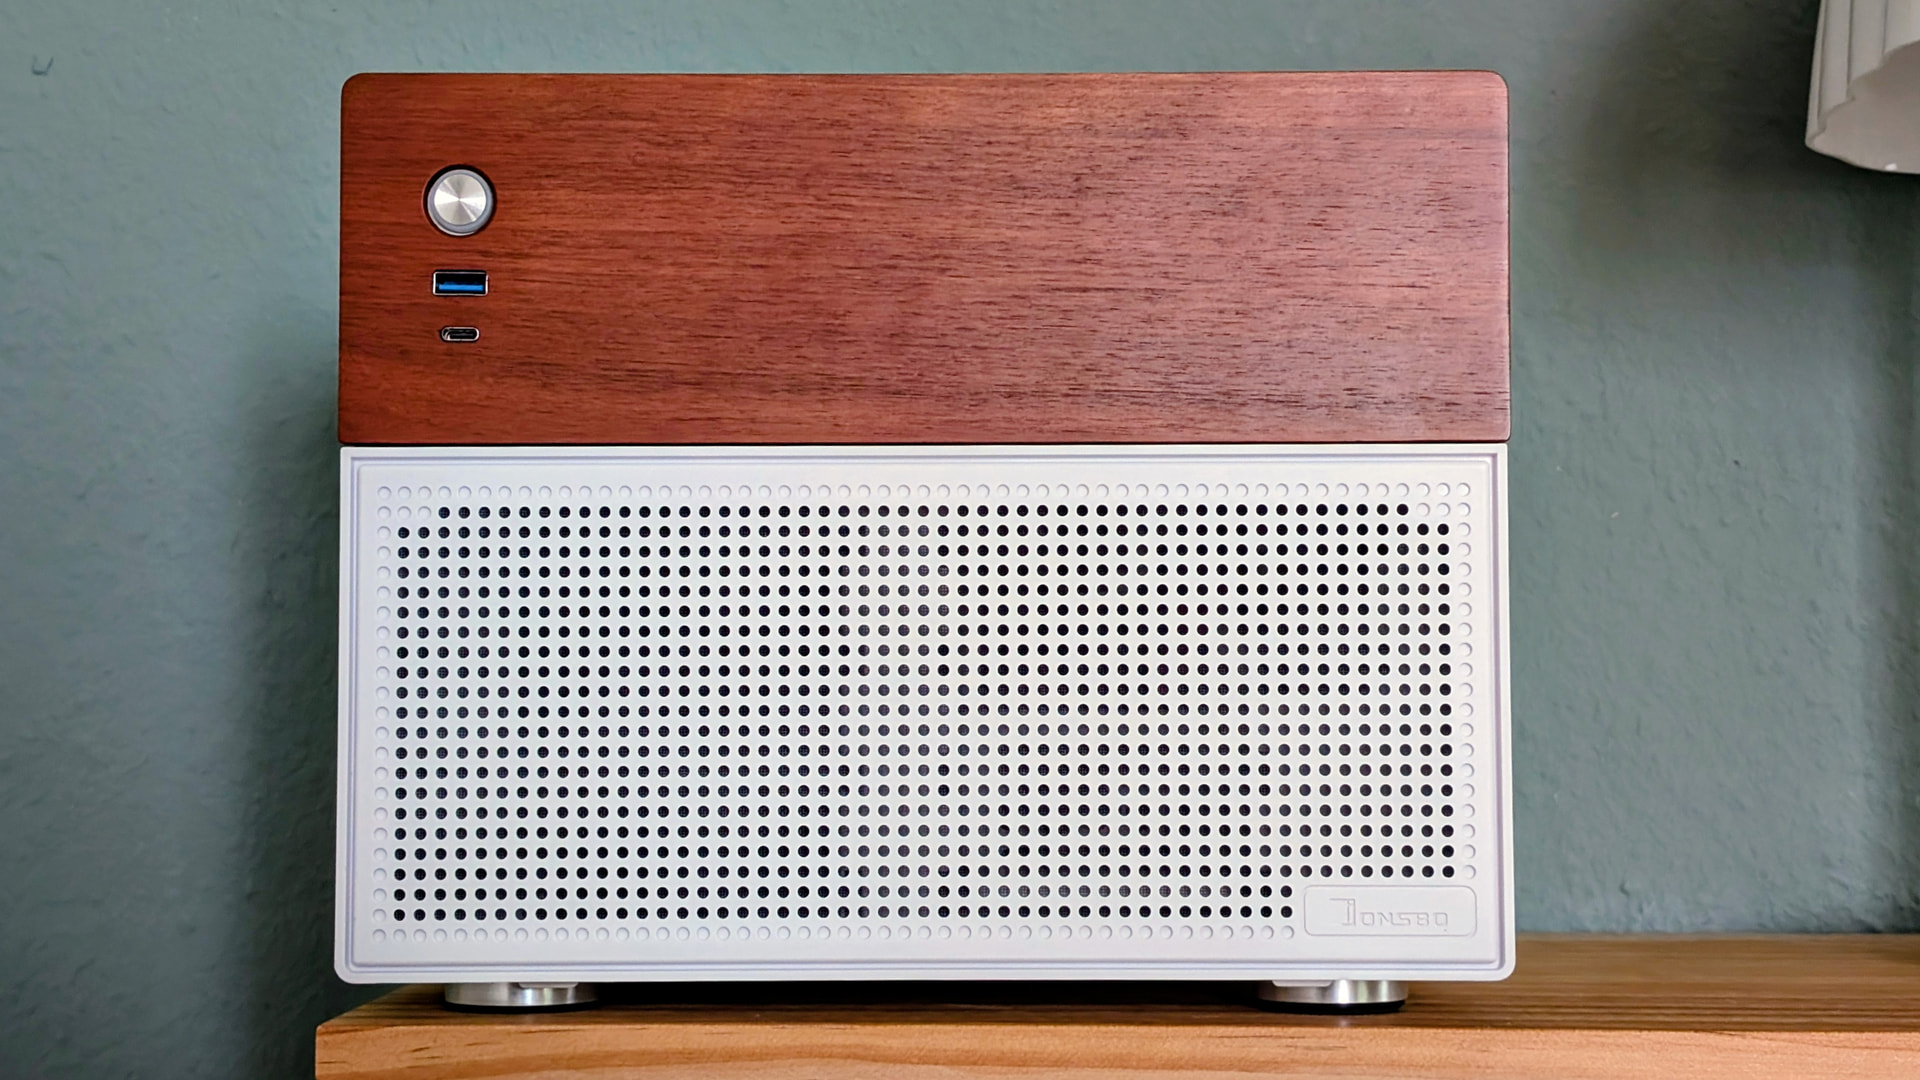
Ich habe das System als komplettes Projekt aufgebaut. Ziel war, NAS und Server in einem Gerät zu kombinieren. Im Jonsbo N4 sind 6× 3,5" und 2× 2,5" Laufwerke möglich, dazu laufen Paperless, Ollama, n8n usw.

Deshalb war eine effiziente GPU wichtig. Die RTX 2000/4000 Ada im SFF-Format kommen mit maximal ca. 70 W aus. Für einen 24/7-Server finde ich das deutlich sinnvoller als eine große Gaming-GPU.

16 GB VRAM reichen für diesen Anwendungsfall aus. Größere Modelle profitieren natürlich von 32 oder 64 GB, aber für Rechnungsverarbeitung und viele lokale KI-Anwendungen sind 16 GB bereits gut nutzbar.

Da die NVIDIA-Karten inzwischen sehr teuer geworden sind, habe ich bei diesem Projekt eine Arc Pro B50 mit 16 GB GDDR6 eingesetzt. Sie läuft stabil mit Ollama und erfüllt den vorgesehenen Zweck gut.

Das komplette System hat etwa 1.500 € gekostet und wurde von mir selbst im Jonsbo N4 aufgebaut. Aktuell arbeite ich bereits an einem größeren System mit 9 Festplatten und einer RTX 2000 Ada.